d1-2B e d1-Omni-2B di Liquid AI: decisioni in 6 ms, senza generare testo
Niente token, solo decisioni: due modelli da 2B che rispondono in 6 millisecondi.
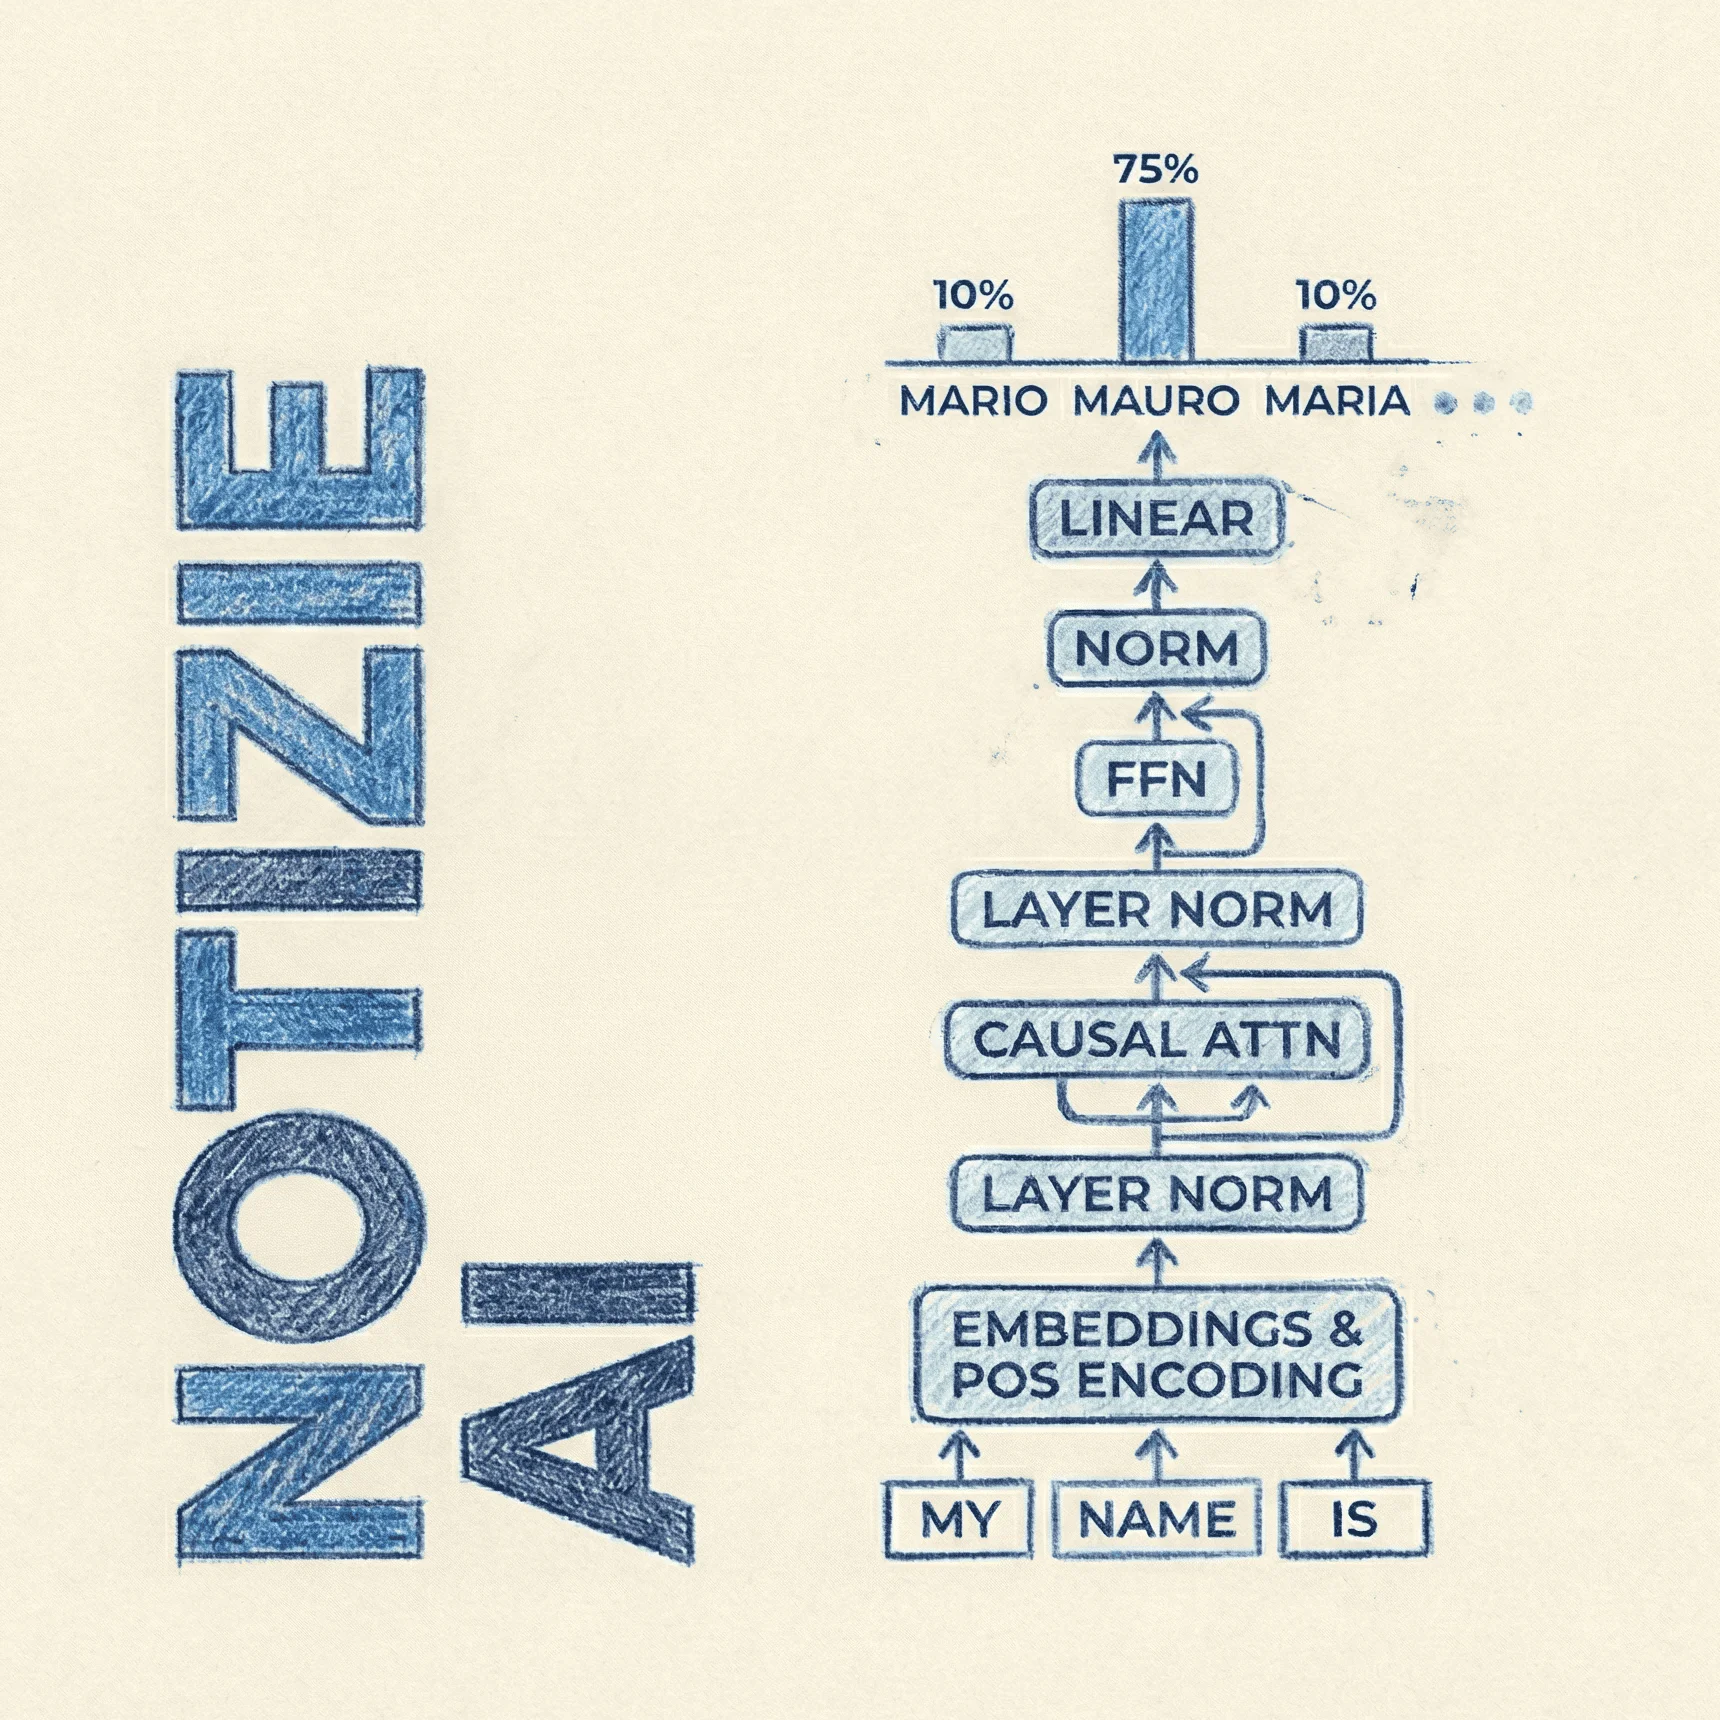
Insieme alla famiglia LFM3, Liquid AI ha rilasciato due decision model open-weight: d1-2B, per testo, immagini e video, e d1-Omni-2B, che aggiunge l'audio. Non generano testo: leggono un input, rispondono a tutte le domande in un solo forward pass e restituiscono per ogni risposta una probabilità. Su una GPU NVIDIA H100 una decisione richiede circa 6 millisecondi.
In questa guida vediamo come funziona un decision model, quali tipi di domanda supportano i modelli d1, cosa dicono i benchmark di Liquid AI e come si posizionano sul Decision Index, la leaderboard indipendente dove i modelli migliori hanno oltre 10 volte i parametri. Chiudiamo con quattro casi d'uso e i comandi per eseguirli in locale con llama.cpp e i GGUF Q8_0.
- Decision model rilasciati
- 2
- Parametri
- 1,92 B / 2,17 B
- Latenza per decisione su H100
- 5,7 ms
- Token generati
- 0
In questa guida
Cos'è un decision model
Un LLM classico risponde generando token uno dopo l'altro. Per decisioni semplici, come scegliere il team che deve gestire un ticket, è un processo lento e difficile da controllare: la risposta va parsata, può uscire dal formato atteso e non dice quanto il modello sia sicuro.
Un decision model lavora in modo diverso. Riceve uno state (un testo, un JSON, immagini, video o audio) e un insieme di domande con un nome e un tipo. In un solo forward pass legge lo state e restituisce per ogni domanda una risposta tipizzata con le relative probabilità. Non c'è sampling e non ci sono token in output.
L'interfaccia segue la System One API introdotta da TypeSafe con il suo modello hosted Jev, oggi riprodotta da molti laboratori e progetti open. Lo stesso schema di richiesta funziona sull'API di TypeSafe, sull'endpoint /v1/systemone di llama.cpp e, con il metodo system_one, nel codice Transformers dei modelli d1.
d1-2B e d1-Omni-2B in sintesi
Entrambi i modelli derivano dal backbone LFM3: d1-2B da LFM3-VL-2B, d1-Omni-2B da LFM3-Omni-2B. Ereditano quindi i 24 layer tri-ibridi (13 gated short convolution, 5 sliding-window attention e 6 global attention), il contesto da 128K token e le 16 lingue supportate, italiano incluso. Trovi i dettagli dell'architettura tri-ibrida nella nostra guida a LFM3.
| Caratteristica | d1-2B | d1-Omni-2B |
|---|---|---|
| Modello di partenza | LFM3-VL-2B | LFM3-Omni-2B |
| Parametri | 1,92 B | 2,17 B |
| Input | State (testo o JSON), immagini, video | State, immagini, video, clip audio, domande scritte o a voce |
| Output | Risposte tipizzate con probabilità | Risposte tipizzate con probabilità |
| Contesto | 128K token | 128K token |
| Lingue della voce | Nessun input audio | Le 16 lingue testuali tranne hindi, thai, vietnamita e indonesiano |
| GGUF Q8_0 | 1,85 GB + mmproj 0,20 GB | 1,85 GB + mmproj 0,33 GB |
La scelta è semplice. Usa d1-Omni-2B solo se le decisioni dipendono da ciò che si sente: messaggi vocali, chiamate, eventi sonori. Senza audio la model card stessa consiglia d1-2B, che è più forte su testo e box singoli, segnala più spesso i valori mancanti ed è calibrato meglio.
I tipi di domanda supportati
Ogni domanda ha un nome scelto da te, un type e le instructions. Con un'unica chiamata puoi porre più domande di tipo diverso sullo stesso state.
| type | Domanda | Risposta | llama.cpp |
|---|---|---|---|
| noul | Sì o no | noul: la probabilità del sì | Sì |
| choice | Una tra le opzioni in criteria | choice, confidence, probabilities | Sì |
| choice con multiple: true | Tutte le opzioni pertinenti | choices, probabilità per opzione | No |
| score | Uno tra 2 e 10 livelli ordinati | score, confidence, probabilities, legend | Sì |
| text, number, date | Un valore da leggere nello state | Il valore, lo span di origine e found | No |
| number con range | Una stima | Mediana e intervallo p10-p90 | No |
| box, boxes | Un oggetto o tutte le istanze in una foto | Coordinate normalizzate, found, count | No |
Un valore o un box viene considerato mancante quando found è sotto 0,5, e in quel caso la risposta è None. Questo permette di distinguere "il campo non c'è" da "il modello ha letto un valore sbagliato".
Benchmark: d1-2B, d1-Omni-2B e d1-3B
Liquid AI ha valutato i quattro modelli open della famiglia d1 sugli stessi item e con lo stesso scoring. Il confronto più interessante è con d1-3B, il modello rilasciato a inizio ottobre e basato su LFM2.5-VL-3B.
| Benchmark | d1-2B | d1-Omni-2B | d1-3B | d1-omni-600M |
|---|---|---|---|---|
| Decision Index, public suite (v0.3) | 51,1 | 49,0 | 49,0 | 18,3 |
| Decision Bench (decisionbench.ai) v4 | 85,2 | 84,7 | 83,6 | 57,9 |
| DecisionBench (Hanno Labs) v1 | 77,1 | 76,4 | 73,1 | 58,7 |
| ImajevBench v2.0-lite | 75,5 | 72,3 | 64,0 | 21,7 |
| WorkflowEvals | 81,6 | 77,1 | 74,4 | 48,8 |
| Typed Decisions | 61,3 | 63,1 | 65,0 | 57,5 |
| Board interna (oltre 100 benchmark) | 63,2 | 61,8 | 58,8 | n.d. |
| MMStar | 67,5 | 61,3 | 59,9 | 31,9 |
| HallusionBench | 72,1 | 67,5 | 65,3 | 52,6 |
| VisualWebBench | 96,2 | 88,6 | 71,4 | 14,9 |
| AI2D | 76,7 | 71,5 | 79,9 | 37,1 |
| Media dei benchmark pubblici | 70,2 | 67,7 | 65,4 | 42,8 |
Con il 62% dei parametri, d1-2B supera d1-3B in 24 dei 27 benchmark pubblicati (calcolo nostro), con un margine di 11,5 punti su ImajevBench. d1-3B resta avanti su AI2D, Typed Decisions e Fast Decisions. d1-Omni-2B segue d1-2B a breve distanza e lo supera solo su Typed Decisions e POPE: il costo dell'audio sulle altre modalità è contenuto.
Come leggere la media
La media è non pesata e include solo i benchmark pubblici disponibili per tutti e quattro i modelli, quindi esclude Fast Decisions e la board interna. I benchmark di immagini sono letti come decisioni sulle opzioni di ogni dataset, su al massimo 1.000 righe ciascuno. Secondo Liquid AI tre di questi sono saturi: POPE, MME e VisualWebBench.
Domande a voce: quanto perde d1-Omni-2B
La capacità distintiva di d1-Omni-2B è decidere su ciò che sente. Liquid AI ha misurato ogni test due volte, con il testo scritto e con lo stesso contenuto letto ad alta voce, su clip e voci mai viste in training. I punteggi sono effective accuracy: 0 equivale al caso, 100 a tutte le risposte corrette.
| Test | Scritto | Ascoltato | Differenza |
|---|---|---|---|
| Domande a voce su task assenti dal training | 45,2 | 44,7 | -0,5 |
| Lingua parlata, 43 lingue (FLEURS) | 92,4 | 92,5 | +0,1 |
| JevBench v1.4.1, righe pronunciabili | 87,6 | 89,0 | +1,4 |
| Comandi per assistenti, speaker reali (SLURP) | 87,4 | 81,7 | -5,7 |
| DecisionBench, routing e triage | 83,4 | 78,2 | -5,2 |
| Nessuna opzione applicabile (astensione) | 78,5 | 75,8 | -2,7 |
| Comandi per assistenti in 12 lingue (Speech-MASSIVE) | 85,2 | 63,4 | -21,8 |
| State brevi letti a voce | 42,0 | 22,8 | -19,2 |
| Belebele, passaggi in 8 lingue | 83,6 | 41,8 | -41,8 |
Il risultato dipende da quanto contenuto passa dalla voce. Quando la voce porta una domanda o un comando breve, la perdita è minima: meno di un punto sulle domande nuove, circa 5 punti su routing e comandi reali. Quando la voce porta molto contenuto, come un passaggio lungo o uno state completo, l'accuratezza crolla: Belebele dimezza. La model card avverte che il calo è più forte nelle lingue che non usano l'alfabeto latino.
Sul riconoscimento di eventi sonori (ESC-50) il modello ottiene 84,5 punti.
Il confronto con modelli 10 volte più grandi
Le model card confrontano d1-2B solo con altri modelli Liquid AI. Per un confronto esterno abbiamo usato il Decision Index, una leaderboard indipendente mantenuta dalla community su Hugging Face. Valuta 244 decision model sulla stessa suite di 37 benchmark pubblici (110.201 richieste) e su test privati che nessuno può usare in training. Ogni benchmark è corretto per il caso: 0 significa risposta casuale, 100 risposta perfetta.
La classifica principale, il Full score della versione 0.4.1, usa solo test privati: per il 60% test privati sulle stesse competenze della suite pubblica, per il 40% task privati di domini nuovi. Il punteggio pubblico è mostrato accanto ma non conta.
| Modello | Parametri | Public index | Full score |
|---|---|---|---|
| d1-2B | 1,9 B | 51,1 | Non ancora in classifica |
| d1-Omni-2B | 2,2 B | 49,0 | Non ancora in classifica |
| d1-3B | 3,1 B | 48,99 | 31,12 |
| vLLM-SR d3-nano | 2 B | 42,22 | 34,30 |
| StartLux-Decision v1.1 2B | 2 B | 59,23 | 40,11 |
| Decider 35B-A3B | 35 B | 47,70 | 46,64 |
| Jev 1.14 (TypeSafe, API hosted) | n.d. | 60,70 | 60,24 |
| vLLM-SR d3 | 27 B | 65,45 | 67,15 |
| Perplexity Decider v1.2 | 27 B | 67,74 | 67,98 |
| vLLM-SR d3-ultra | 27 B | 71,57 | 70,18 |
Sulla suite pubblica il 51,1 di d1-2B lo collocherebbe intorno al 114esimo posto su 244 (calcolo nostro). È sopra d1-3B, sopra vLLM-SR d3-nano della stessa taglia e sopra Decider 35B-A3B, che ha oltre 18 volte i parametri. I decision model da 27B, circa 14 volte più grandi, restano però avanti di 14-20 punti, e anche Jev di TypeSafe lo supera di quasi 10.
Il punteggio pubblico di d1-3B sulla leaderboard (48,99) coincide con quello riportato da Liquid AI (49,0): la misura di Liquid sulla public suite è quindi affidabile.
Velocità: decisioni in millisecondi
Poiché non generano token, i decision model si misurano in latenza end-to-end. Liquid AI riporta chiamate "a caldo" in BF16 con Transformers dopo model.compile(), che alla prima esecuzione richiede circa un minuto.
| Hardware | Una domanda | 3 domande | State da 5K token | Immagine 384 px | Clip audio 10 s | 64 state in una chiamata |
|---|---|---|---|---|---|---|
| NVIDIA H100 PCIe | 5,7 ms (5,8) | 7,6 ms (7,7) | 52 ms (52) | 12,3 ms (12,1) | n.d. (12,4 ms) | 1.132/s (1.154) |
| AMD MI325X | 3,8 ms (3,7) | 5,6 ms (5,6) | 44 ms (43) | 8,7 ms (8,6) | n.d. (8,2 ms) | 1.699/s (1.697) |
| Apple M5 Pro (mps) | 18,6 ms (21,1) | 26,5 ms (28,9) | 753 ms (694) | 45,2 ms (40,2) | n.d. (33,3 ms) | 109/s (110) |
Tre domande costano appena il 33% in più di una, perché lo state viene letto una sola volta. Anche su un Mac con Apple M5 Pro una decisione su un'immagine richiede meno di 50 ms. Il collo di bottiglia sono gli state lunghi: 5K token di testo richiedono 0,75 secondi su M5 Pro. Questi numeri non valgono per llama.cpp, che ha prestazioni proprie.
Eseguire d1 con llama.cpp in Q8_0
Il supporto ai modelli d1 è arrivato in llama.cpp v0.8.0 (build b11960) con l'endpoint POST /v1/systemone, compatibile con la System One API di TypeSafe. Entrambi i repository GGUF includono il modello e il projector multimodale in Q8_0.
1. Avvia il server
1. Avvia il server
llama-server -hf LiquidAI/d1-2B-GGUF:Q8_0 -b 8192 -ub 8192 --port 8080
Per d1-Omni-2B usa LiquidAI/d1-Omni-2B-GGUF:Q8_0. Con -hf llama.cpp scarica anche l'mmproj. Funziona anche il comando unificato llama serve con gli stessi flag.
2. Dimensiona il batch
2. Dimensiona il batch
Ogni domanda viene letta in un solo batch, quindi -b e -ub devono contenere lo state e i media. Un'immagine occupa al massimo metà di -ub: con 8192 mantiene il budget pieno di 4096 token, con valori più bassi il budget per immagine scende.
3. Imposta sempre la porta
3. Imposta sempre la porta
Gli esempi delle model card GGUF avviano il server senza --port e poi chiamano 127.0.0.1:8080. In llama.cpp v0.8.0 però la porta di default è 9931: senza --port 8080 le richieste falliscono.
Casi d'uso con i modelli d1
Gli esempi che seguono sono scenari illustrativi. I primi tre usano d1-2B, l'ultimo d1-Omni-2B. I modelli supportano l'italiano, quindi puoi scrivere domande e opzioni in italiano; confronta comunque il risultato con le stesse domande in inglese sui tuoi dati.
Triage dei ticket di assistenza
Scenario: un e-commerce riceve migliaia di messaggi al giorno e vuole assegnarli al team giusto, segnalare le richieste di rimborso e stimarne l'urgenza. Con il server llama.cpp avviato, una sola richiesta risponde a tutte e tre le domande:
import requests

QUESTIONS = {
    "rimborso": {"type": "noul", "instructions": "Il cliente chiede un rimborso?"},
    "team": {
        "type": "choice",
        "instructions": "Quale team deve gestire il messaggio?",
        "criteria": {
            "fatturazione": "Addebiti, rimborsi, fatture",
            "spedizioni": "Consegne e pacchi",
            "tecnico": "Problemi con app o sito",
        },
    },
    "urgenza": {
        "type": "score",
        "instructions": "Quanto è urgente il messaggio?",
        "criteria": ["Può aspettare", "Da gestire oggi", "Blocca il cliente adesso"],
    },
}

def triage(message):
    response = requests.post(
        "http://127.0.0.1:8080/v1/systemone",
        json={"state": message, "questions": QUESTIONS},
        timeout=10,
    )
    response.raise_for_status()
    return response.json()["answers"]

answers = triage("Mi avete addebitato due volte l'abbonamento e il pacco non è mai arrivato.")
team = answers["team"]

if team["confidence"] < 0.6:  # soglia da calibrare sui tuoi dati
    print("Revisione manuale:", team["probabilities"])
else:
    print(team["choice"], round(answers["rimborso"]["noul"], 2), round(answers["urgenza"]["score"], 1))
Il valore confidence va da 0 (tutte le opzioni equiprobabili) a 1. Instradare automaticamente solo i casi sopra una soglia e mandare gli altri a un operatore è il modo più semplice per sfruttare le probabilità.
Estrazione dei dati da una fattura
Scenario: un gestionale deve leggere fornitore, importo e scadenza dalle fatture ricevute via email. L'estrazione di valori non è ancora supportata da llama.cpp, quindi questo esempio usa Transformers:
pip install "transformers>=5.19" torch torchvision pillow
import torch
from transformers import AutoModel

device = "cuda" if torch.cuda.is_available() else "mps" if torch.backends.mps.is_available() else "cpu"
dtype = torch.float32 if device == "cpu" else torch.bfloat16
model = AutoModel.from_pretrained("LiquidAI/d1-2B", trust_remote_code=True, dtype=dtype).to(device)

fattura = (
    "Rossi Forniture S.r.l.\n"
    "Fattura n. 2026/481\n"
    "Totale da pagare: 1.830,00 EUR\n"
    "Scadenza: 15/11/2026 (giorno/mese/anno)"
)

out = model.system_one(fattura, {
    "fornitore": {"type": "text", "instructions": "Chi ha emesso la fattura?"},
    "totale": {"type": "number", "instructions": "Qual è l'importo da pagare?"},
    "scadenza": {"type": "date", "instructions": "Entro quando va pagata?"},
    "iva": {"type": "number", "instructions": "Quanto vale l'IVA addebitata?"},
})

a = out["answers"]
print(a["fornitore"]["text"], a["totale"]["number"], a["scadenza"]["date"], a["iva"]["number"])
Le date tornano in formato ISO 8601 e ogni valore include lo span del testo da cui è stato letto. In questa fattura l'IVA non compare: il campo found resta sotto 0,5 e la risposta è None, invece di un numero inventato. Indicare l'ordine giorno/mese/anno nello state aiuta a evitare ambiguità sulle date.
Controllo visivo dei resi
Scenario: il magazzino fotografa ogni pacco restituito e vuole sapere subito se è danneggiato e che tipo di prodotto contiene. Con llama.cpp le immagini viaggiano come data URL in base64:
curl http://127.0.0.1:8080/v1/systemone -H "Content-Type: application/json" -d @- <<JSON
{
  "state": "Foto di un reso arrivato in magazzino.",
  "images": ["data:image/jpeg;base64,$(base64 < reso.jpg | tr -d '\n')"],
  "questions": {
    "danneggiato": {"type": "noul", "instructions": "La confezione è danneggiata?"},
    "prodotto": {"type": "choice", "instructions": "Che tipo di prodotto si vede?",
                 "criteria": {"elettronica": "Dispositivi elettronici", "abbigliamento": "Vestiti e scarpe",
                              "casa": "Oggetti per la casa", "altro": "Nessuna delle categorie precedenti"}}
  }
}
JSON
L'opzione "altro" dà al modello un modo esplicito per non forzare una categoria sbagliata. Per localizzare il danno con un box, usa il tipo box in Transformers: la risposta contiene le coordinate top, bottom, left e right come frazioni dell'immagine. d1-2B accetta anche video, passati come files con un data URL video/mp4 (serve ffmpeg nel PATH).
Smistamento dei messaggi vocali con d1-Omni-2B
Scenario: un servizio clienti riceve messaggi in segreteria e vuole capire il motivo della chiamata e se il cliente chiede di essere richiamato, senza trascriverli. Avvia il server con LiquidAI/d1-Omni-2B-GGUF:Q8_0 e converti l'audio in wav mono a 16 kHz:
ffmpeg -i messaggio.m4a -ac 1 -ar 16000 -c:a pcm_s16le messaggio.wav

curl http://127.0.0.1:8080/v1/systemone -H "Content-Type: application/json" -d @- <<JSON
{
  "state": "Messaggio lasciato in segreteria dal cliente.",
  "files": ["data:audio/wav;base64,$(base64 < messaggio.wav | tr -d '\n')"],
  "questions": {
    "motivo": {"type": "choice", "instructions": "Perché chiama il cliente?",
               "criteria": {"guasto": "Un prodotto non funziona", "fattura": "Domande su addebiti o fatture",
                            "disdetta": "Vuole disdire il servizio", "altro": "Nessuno dei motivi precedenti"}},
    "richiamare": {"type": "noul", "instructions": "Il cliente chiede di essere richiamato?"},
    "tono": {"type": "score", "instructions": "Quanto è irritato il cliente?",
             "criteria": ["Calmo", "Infastidito", "Molto arrabbiato"]}
  }
}
JSON
Anche la domanda può essere un file audio: in quel caso instructions diventa un oggetto input_audio con la registrazione in base64. Ricorda i limiti visti sopra: i messaggi brevi funzionano bene, i monologhi lunghi perdono molta accuratezza.
Come usare le probabilità in produzione
Il vantaggio pratico di un decision model è che ogni risposta arriva con un numero. Per sfruttarlo serve un minimo di metodo.
1. Raccogli un set etichettato
1. Raccogli un set etichettato
Bastano qualche centinaio di esempi reali, con la risposta corretta per ogni domanda. Includi i casi difficili e quelli in cui nessuna opzione si applica.
2. Calibra le soglie
2. Calibra le soglie
Le probabilità sono scalate con le temperature salvate nel modello, ma llama.cpp avverte che non sono garantite calibrate sui tuoi dati. Scegli la soglia di noul e di confidence in base al costo di un errore: più alto il costo, più alta la soglia.
3. Prevedi un fallback
3. Prevedi un fallback
Sotto soglia, inoltra il caso a un operatore o a un LLM più grande. Così il modello piccolo gestisce in pochi millisecondi i casi chiari e i casi incerti finiscono a chi può risolverli.
4. Monitora nel tempo
4. Monitora nel tempo
Registra la distribuzione delle probabilità. Se cala la quota di risposte sicure, i dati in ingresso stanno cambiando: è il segnale per rivedere le domande o per un fine-tuning.
Licenza e limiti
LFM Open License v1.0
I pesi sono open e scaricabili. L'uso commerciale è consentito alle organizzazioni con un fatturato annuo inferiore a 10 milioni di dollari. Oltre questa soglia la licenza non copre l'uso commerciale, quindi serve un accordo separato con Liquid AI.
Limiti dichiarati
Le domande che richiedono molta conoscenza favoriscono i modelli più grandi. Oltre circa 64K token di state le risposte diventano meno affidabili. Le stime sono affidabili su conteggi e punteggi, meno su quantità libere. d1-Omni-2B perde molta accuratezza su passaggi parlati lunghi.
Domande frequenti sui modelli d1
Che differenza c'è tra d1-2B e LFM3-VL-2B?
Hanno lo stesso backbone, ma LFM3-VL-2B genera testo, mentre d1-2B è addestrato a rispondere a domande tipizzate in un solo forward pass, con probabilità e senza token in output. Per chat, descrizioni o ragionamenti usa LFM3-VL-2B; per decisioni ripetute e misurabili usa d1-2B.
Quale modello d1 devo scegliere?
d1-2B per testo, immagini e video. d1-Omni-2B solo quando la decisione dipende dall'audio, come messaggi vocali, chiamate o eventi sonori. Senza audio d1-2B è più accurato e meglio calibrato.
d1 sostituisce un modello NER?
Solo in parte. Con le domande text, number e date d1 estrae un valore preciso dallo state, per esempio il fornitore o la scadenza di una fattura. Restituisce il valore normalizzato, lo span da cui l'ha letto e found, che indica se il valore c'è davvero. Ogni domanda però restituisce un solo valore: non esiste un tipo per trovare tutte le persone, aziende o luoghi di un testo. Per riempire uno schema noto d1 va bene; per la NER classica serve un modello dedicato come GLiNER. I due approcci si possono combinare: il modello NER trova le entità e d1 prende le decisioni su di esse. L'estrazione richiede Transformers, perché llama.cpp non la supporta ancora.
Quante domande posso fare in una sola chiamata?
Un numero qualsiasi. Il modello legge insieme 16 domande alla volta dopo lo state (parametro set_size in Transformers): valori più alti sono più veloci ma costano un po' di accuratezza sul testo. In llama.cpp le domande di una richiesta vengono risposte in modo indipendente.
I modelli d1 funzionano in italiano?
Sì. L'italiano è tra le 16 lingue di entrambi i modelli, e d1-Omni-2B lo supporta anche per le domande e i contenuti a voce.
Quale versione di llama.cpp serve?
llama.cpp v0.8.0 (build b11960) o successiva. Supporta domande noul, choice e score su testo, JSON, immagini, video e, per d1-Omni-2B, audio. Per scelta multipla, estrazione, stime e box serve Transformers.
d1-2B è migliore dei decision model più grandi?
No. Sulla suite pubblica del Decision Index supera d1-3B e Decider 35B-A3B, ma resta 14-20 punti sotto i migliori modelli da 27B. Il suo vantaggio è il rapporto tra qualità, latenza e memoria: gira on-device e decide in pochi millisecondi.
Fonti
Dati aggiornati al 29 ottobre 2026. I benchmark dei modelli d1 sono quelli pubblicati da Liquid AI e non li abbiamo verificati in modo indipendente. I valori del Decision Index vengono dalla leaderboard pubblica (versione 0.4.1, 28 ottobre 2026). Il conteggio dei benchmark vinti, la posizione stimata sulla suite pubblica e i rapporti tra parametri sono calcoli nostri. I comandi seguono la documentazione ufficiale di llama.cpp e delle model card, mentre i casi d'uso sono esempi illustrativi.
References
- Hugging Face: model card LiquidAI/d1-2B
- Hugging Face: model card LiquidAI/d1-Omni-2B
- Hugging Face: LiquidAI/d1-2B-GGUF
- Hugging Face: LiquidAI/d1-Omni-2B-GGUF
- Liquid AI: Introducing LFM3, Every Modality for Specialized Intelligence (27 ottobre 2026)
- Liquid AI: Open d1, Edge decision models for text, vision, and audio (7 ottobre 2026)
- Hugging Face Space: Jev Decision Index, leaderboard e metodologia
- Decision Index: dati della leaderboard (data/v03.json)
- TypeSafe: System One API reference
- GitHub: README del server llama.cpp (v0.8.0)
- Hugging Face: LFM Open License v1.0